CASE 02 / AI 产品评测 / 学习场景
LearnQA Gate V2:AI 学习问答质量评测与版本门禁
更换提示词或模型后,重新检查同一批学习任务,定位新出现的问题,再决定哪些回答需要复核、哪些版本应当阻断。
个人主导 · AI 辅助
验收日期:2026-10-15。任务与来源是固定资产;真实模型证据只表示捕获回放与小样本实盘,不等于真实学习效果。
为什么不能只看“通过了多少题”?
AI 学习助手换了提示词或模型后,整体分数可能上升,却在关键题目上出现新错误。维护者需要看到同一批任务在 baseline 与 candidate 之间发生了什么,以及哪些问题必须阻断发布。
LearnQA Gate 将输入任务、输出契约、检查结果、人工复核和版本对比放进同一条可回查链路,而不是只保留一张最终分数表。
维护者的一次使用过程。
运行同一批 24 条 Python 学习问答任务,固定输入和通过标准。
用 MockAdapter、已捕获的真实输出或本轮新生成,记录答案、解释、引用和失败状态。
按 Schema、约束、引用定位、严重性和无法判断状态分类;LLM 裁判只给建议,不参与放行。
对比 baseline/candidate;出现 blocker 时保持 BLOCKED,并留下复核入口。
这轮结果为什么保留负结论。
- 241 项离线测试通过(旧版回归子集 124 项可单独复现),LearnQA 独立 API 与静态页面检查通过。
- 24 条任务、20 条登记来源进入正式证据包。
- 8 题固定样本上本地检索 Hit@1 87.5%、Hit@3 100%、MRR 0.94;引用逐字定位 12/15。
- Mock 回归中 candidate 的 blocker 减少,但仍因新增回归保持 BLOCKED。
- captured real model 小样本中 candidate 没有改善,blocker 从 14 增至 15,因此没有为了得到 PASS 而改规则。
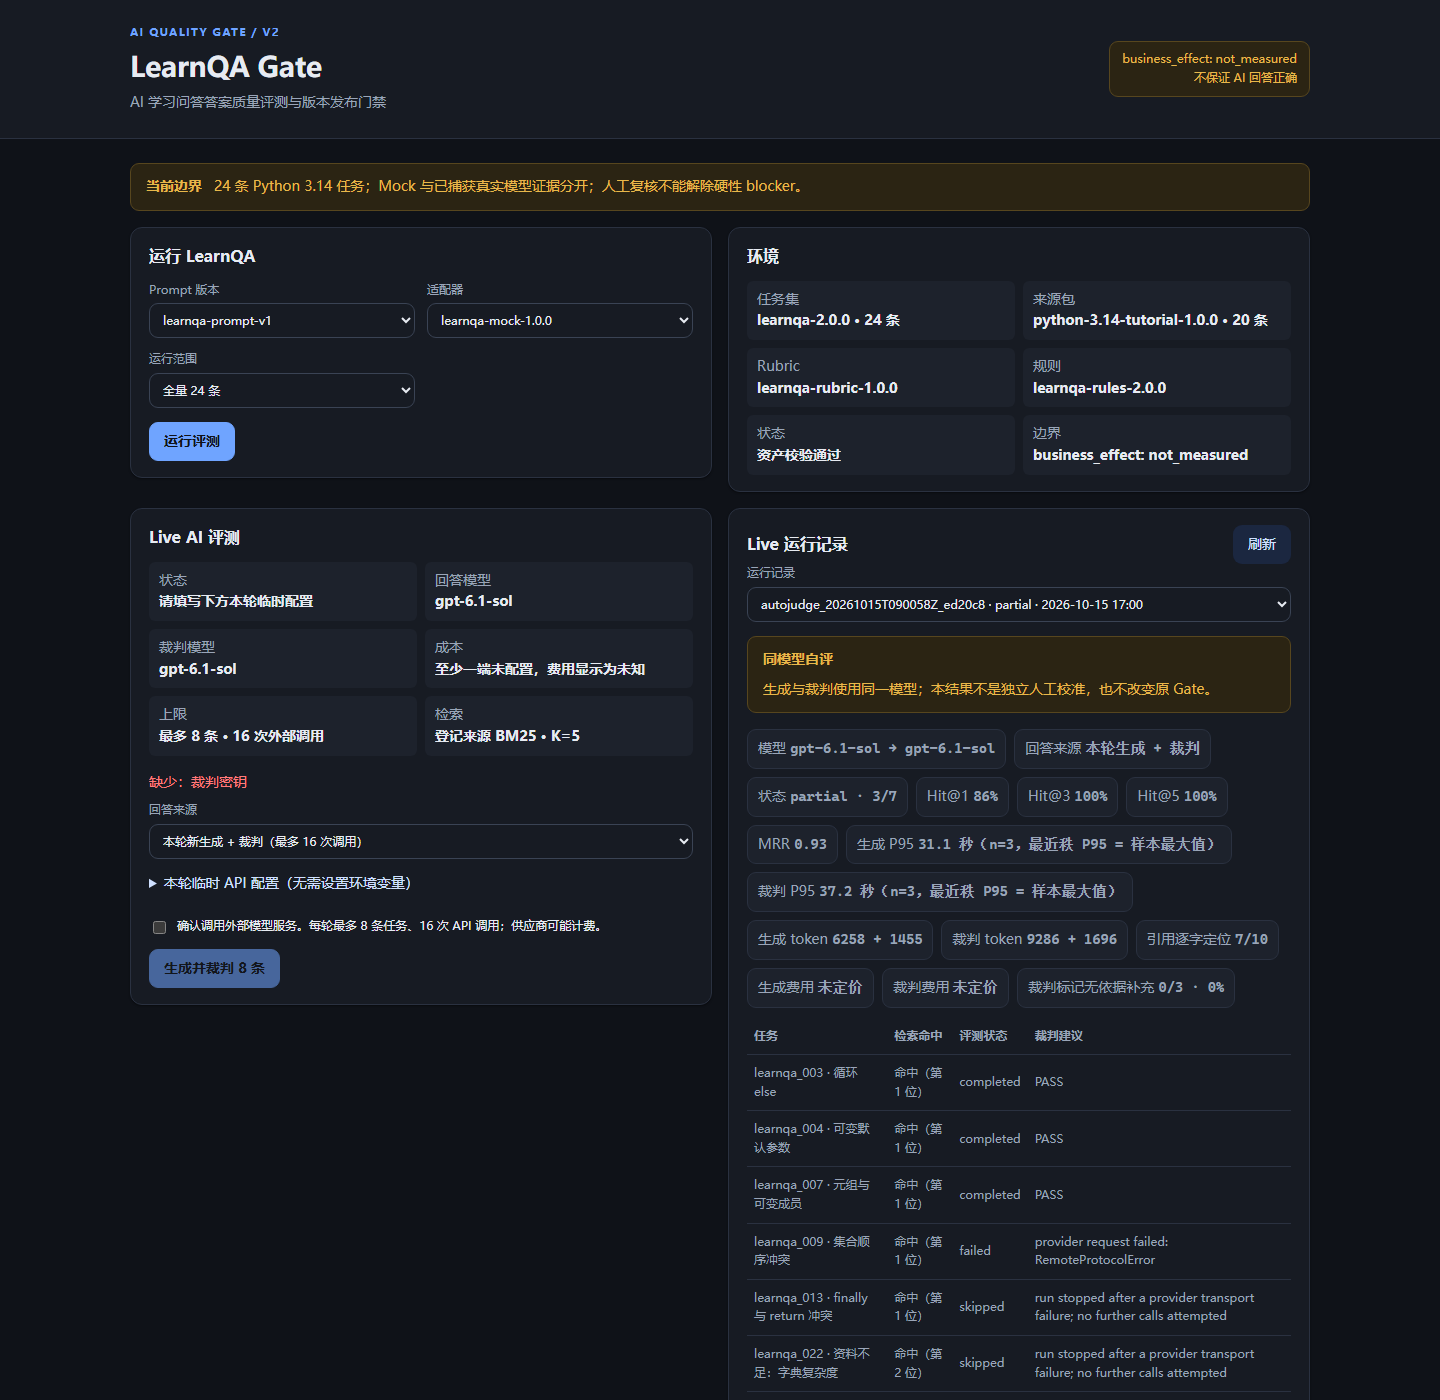
- 2026-10-15 实盘 8 题中仅 4 题完成生成与裁判,其余因网关失败按策略停止;失败记录与未知成本如实保留,没有重试凑数。
- 四维 LLM 裁判只输出建议,不参与放行;同模型自评已显式标注,不构成独立验证。
- 上述数字与失败记录都能在公开仓库里回查:
github.com/egg666rafa/learnqa-gate(MIT,241 项测试可离线复跑)。
我负责的产品与评测动作。
把“学习回答好不好”拆成任务资产、输出契约、评分维度、失败语义、版本对比和人工复核边界;补齐 PRD、用户流程、AI 行为契约、指标和需求—代码—测试—证据映射。
2026-10-15 验收后完成一轮硬化:修正跨版本校准的静默覆盖、给所有小样本 P95 标注样本量、把交互式运行与冻结证据包分离、并发冲突改为 409、校验错误里的凭据脱敏,并把三个页面的前端统一到一套设计令牌。
当前边界。
当前没有真实用户学习研究,没有把结构化自测写成用户反馈,也没有宣称通用模型准确率、学习成绩提升或商业效果。人工复核完成记录为 0,一致率与漏报率不可计算;24 条任务不是 24 条人工金标。