AI FULL-STACK
AI 全栈应用开发 / Agent 开发
面向 AI 全栈应用开发、Agent 开发与 AI 应用开发岗位,突出工具调用治理、RAG 检索与引用校验、评测门禁,以及 Vue / Spring Boot 全栈实现。
- 从 Agent 运行时、RAG 引用校验到对抗评测的完整链路
- Python / Java 后端 + Vue 3 前端 + MySQL 索引与缓存
- 每个项目都写清验证数字与还没做到的边界
AI 全栈 / Agent 开发版与 AI 评测质量版。
02 / 能力证据每项先说明使用场景,再展开我的动作与验证。
03 / 长期实践自媒体、小说与从真实需求长出的工具。
UPDATED 2026.10 / 本轮升级
ROLE-BASED RESUMES / 01
两版简历共用相同事实,但按岗位重新组织能力、项目顺序与技术证据。
AI FULL-STACK
面向 AI 全栈应用开发、Agent 开发与 AI 应用开发岗位,突出工具调用治理、RAG 检索与引用校验、评测门禁,以及 Vue / Spring Boot 全栈实现。
AI EVALUATION
面向大模型评测、AI 应用评测和 Agent 质量岗位,突出测试集、Bad Case、版本回归、问题闭环和评测报告。
公开简历包含手机号与邮箱,用于招聘联系;项目数据仍区分固定案例、历史验收、团队成果和真实用户结果。
SELECTED WORK / 02
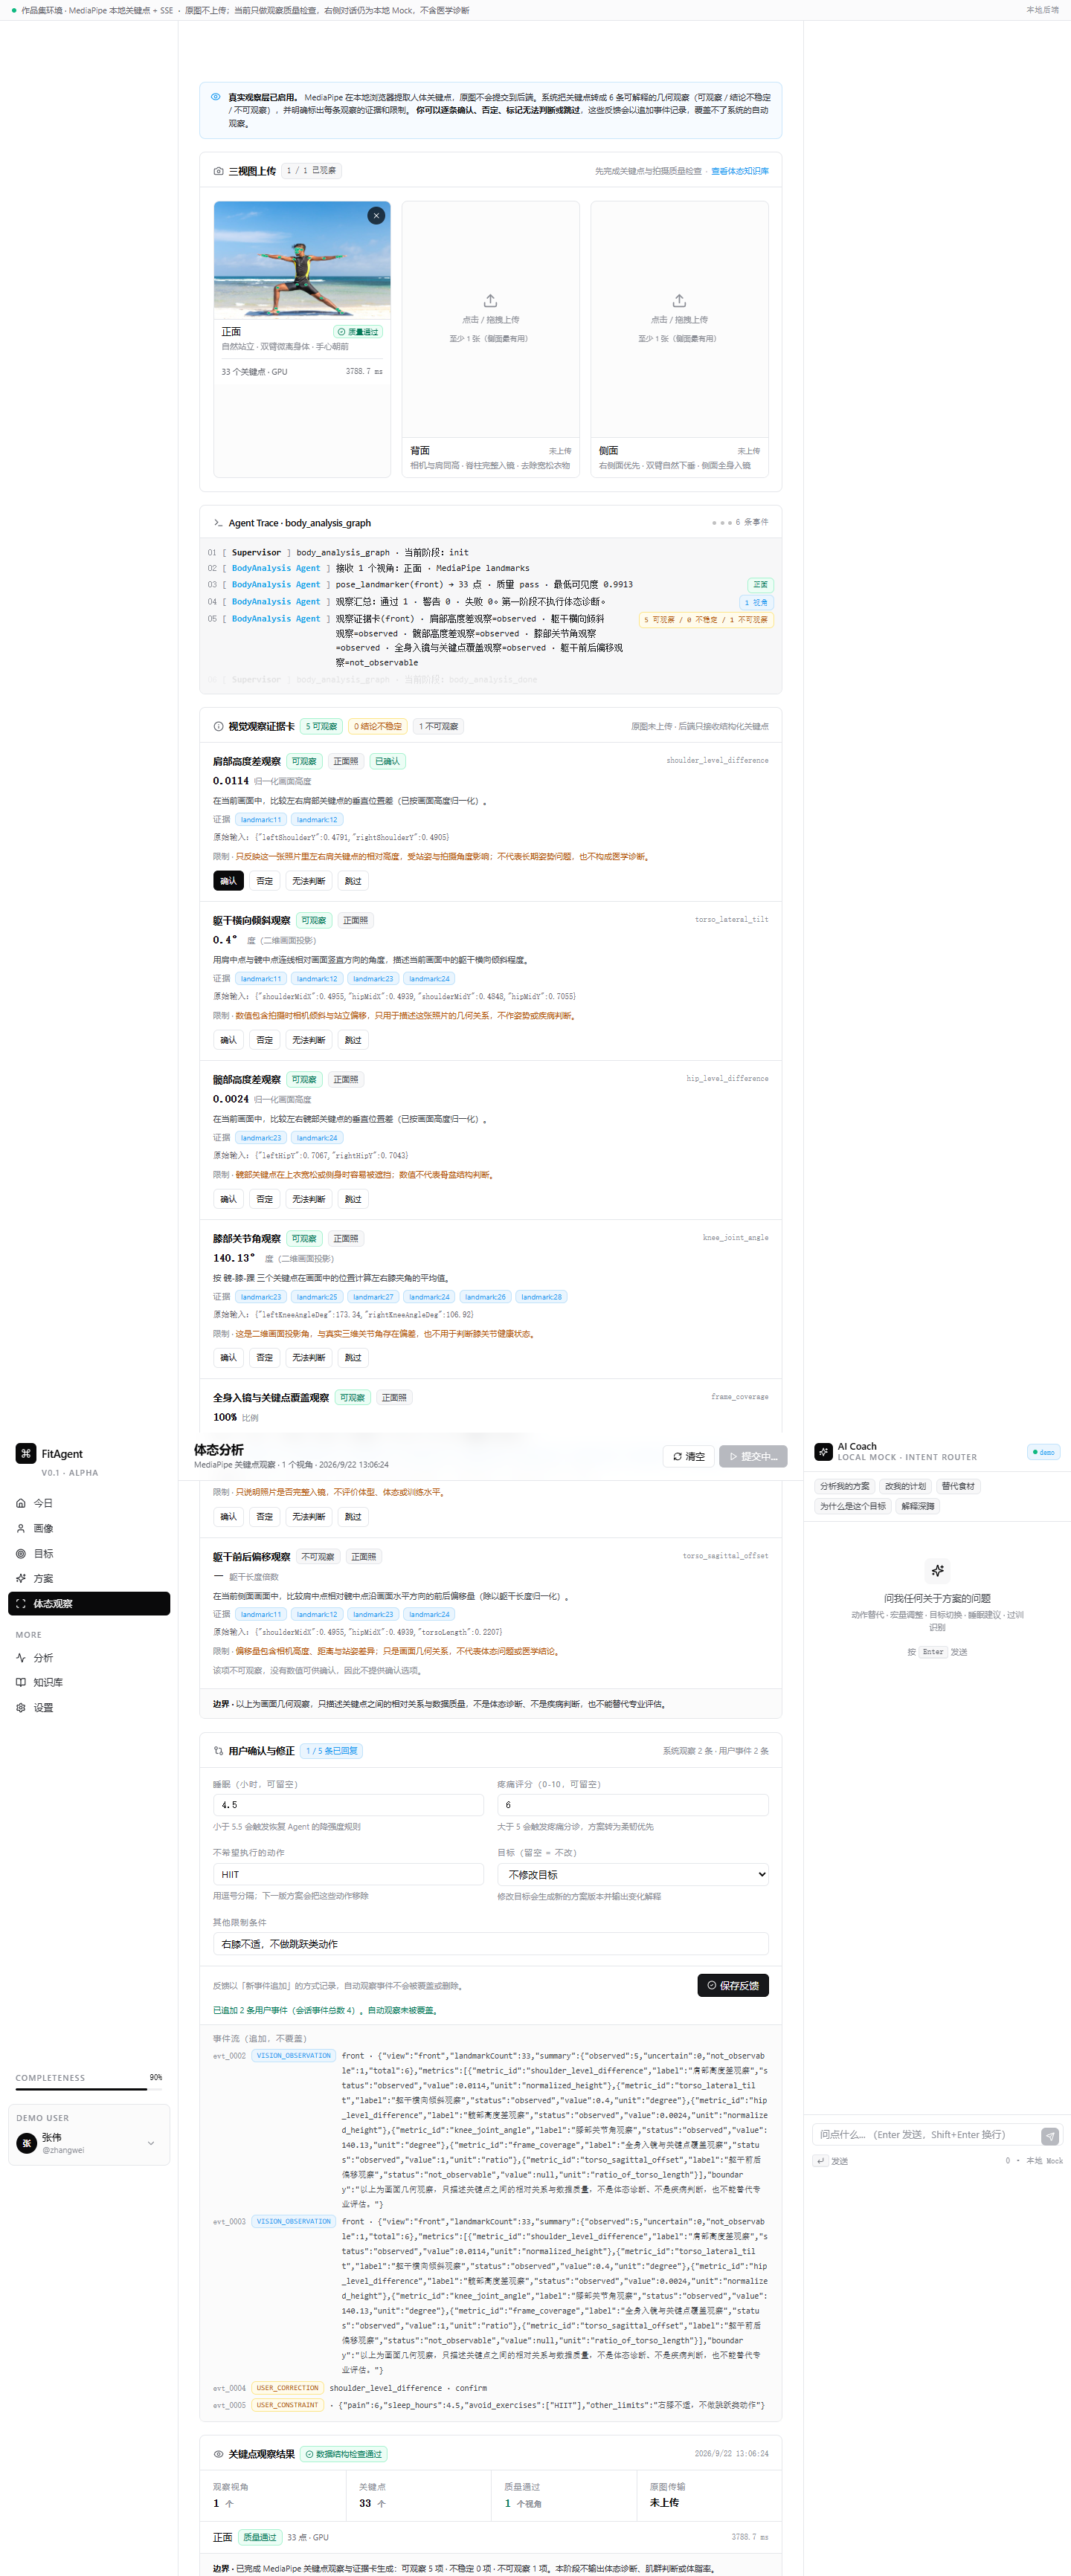
 02
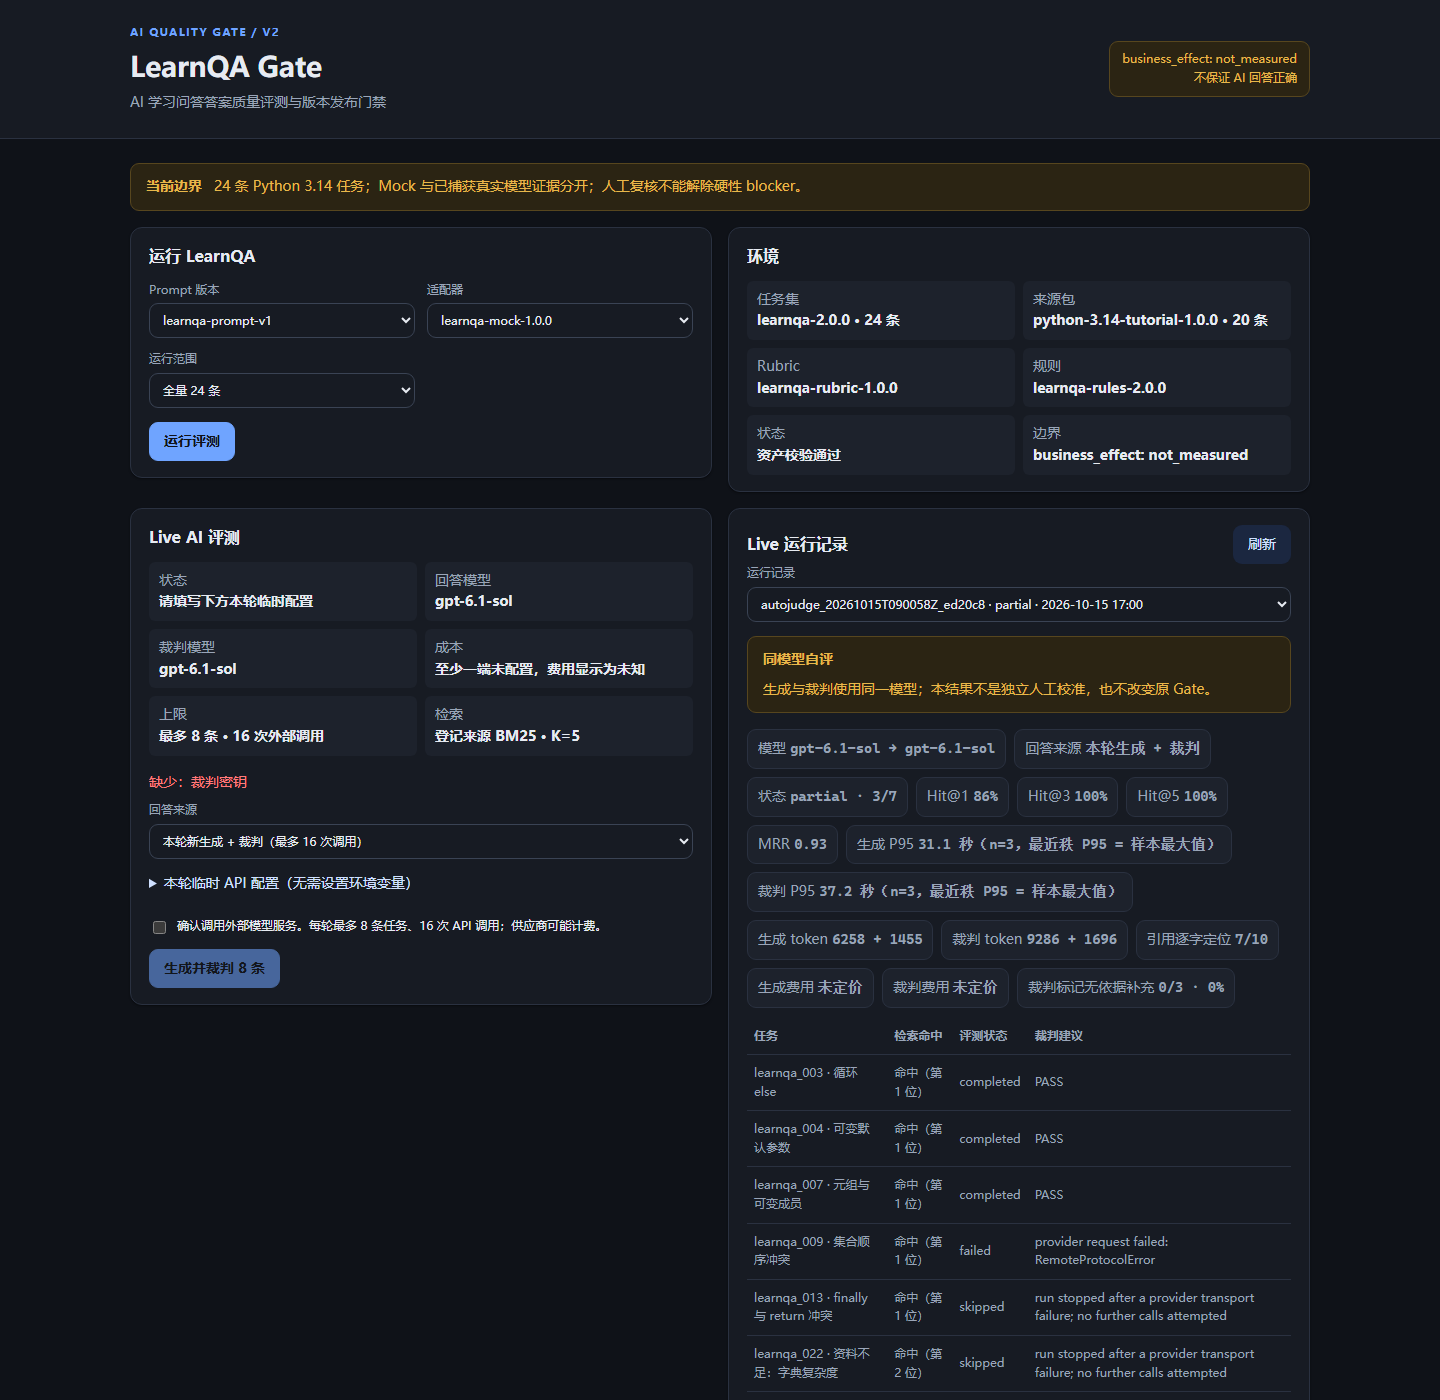
AI 产品评测 / 学习场景
AI 学习问答质量评测与版本门禁
用途:给维护 AI 学习助手的人使用:更换提示词或模型后,重新检查同一批题目的答案、解释和引用,定位新出现的问题,决定哪些回答需要复核、哪些版本应当阻断。
验证2026-10-15:241 项离线测试通过(旧版回归子集 124 项可单独复现);24 条任务、20 条登记来源;8 题固定样本上本地检索 Hit@1 87.5%、MRR 0.94;真实模型证据显示 candidate 未改善,版本保持 BLOCKED。
边界当前是固定合成任务与小样本捕获回放;裁判只给建议且同模型自评不构成独立验证;人工复核完成记录为 0,一致率不可计算;不代表真实学习效果、通用模型准确率或真实用户研究。
 03
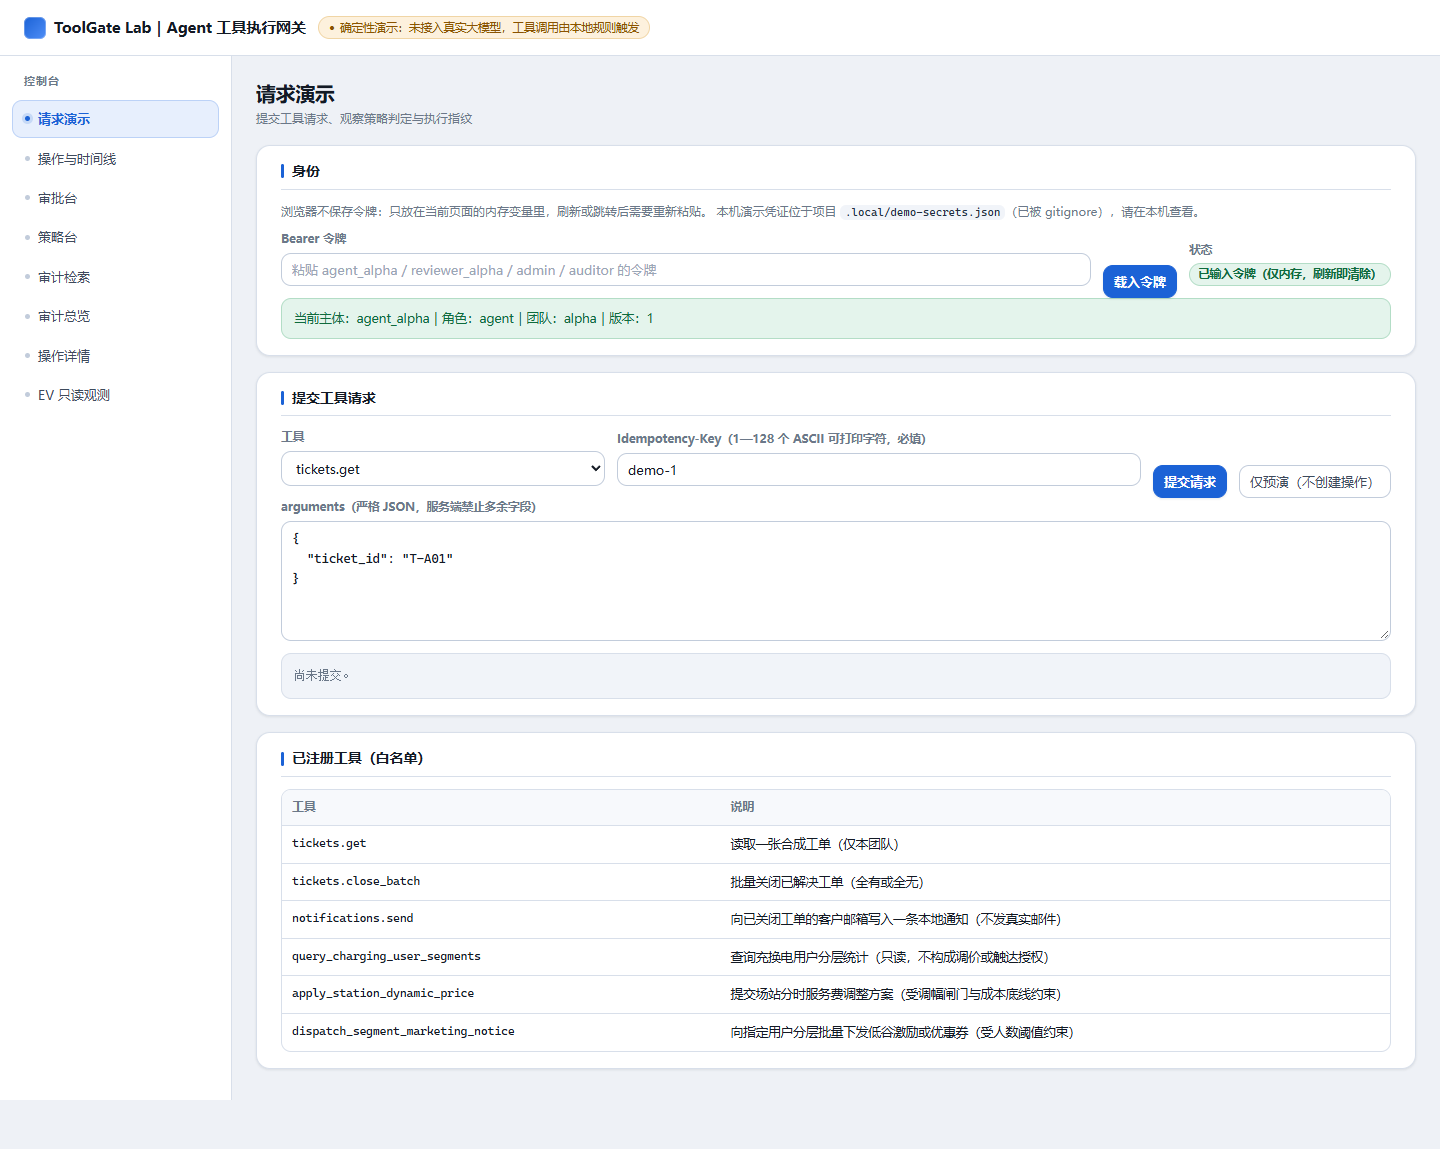
Agent 工程 / 工具治理与评测
Agent 工具执行网关与受控 LLM / RAG 运行时
用途:当 Agent 准备调价、批量关单或群发通知时,先核对它引用的依据、权限与审批;执行没有回包时先查清是否已经发生,再决定要不要重试。风险操作按幅度自动放行、转审批或直接阻断。
验证2026-10-15:全量 329 项测试通过(存量 168 + 新增 161);30 条对抗用例双模式对比,越权拦截率 0% → 100%、期望一致率 23.3% → 100%、引用准确率 93.1%;138 个源文件哈希比对意外修改为 0,66/66 项存量验收 ID 完整。
边界整体判定 PARTIAL:容器端到端与真实厂商模型两项未运行;RAG 引用校验位于编排层,尚未成为网关强制门禁;未接入付费模型,也不声称能判断引用与结论的语义相关性。
 04
首页只放四个代表项目;其他实践按创作工具、开源改造、方法评测和探索中分类,避免把不同完成度的条目混成同一种“成熟产品”。
BEYOND THE BUILD / 03
ABOUT THE PERSON
我不希望只用技术栈介绍自己。学习、创作、做工具,都是我理解现实的方式。
关于我与我的工作方式