CASE 02 / DATA ENGINEERING & PERFORMANCE
长内容工作台:创作资料治理与质量分析
把散落的章节、版本与复盘,变成可查询、也可优化的数据。
个人主导 · 真实创作场景;AI 辅助原型实现与验收
2026-10-15 · 在原有原型上完成索引、缓存与作者数据范围隔离升级。性能数字为本机单次实测(MySQL 8.4 · 99,000 行),重跑约 20% 浮动,不构成通用性能承诺。
长内容生产的问题,不只在生成正文。
持续创作要维护大纲、章节卡、人物状态、版本和复盘。材料一旦分散,设定冲突、版本混乱和问题重复出现就难以定位。我的实际需求是先把过程组织清楚,再让数据可检查。
数据量从几百条涨到十万条之后,第二个问题出现了:那条「按作品、章节状态和日期范围过滤,再按日期与章节排序」的查询开始变慢,界面打开要先等它。
先组织流程,再实现数据原型。
- 创作:选题与样本 → 大纲与章节卡 → 正文生成与人工修改。
- 复盘:连续性检查 → 问题归类 → 版本记录 → 下一轮规则。
- 治理:来源登记 → 清洗留痕 → 幂等导入 → 结构化查询。
- 分析:质量分析任务 → 按作品聚合 → 结果明细回查。
系统保存标题、序号、字数和复盘问题等必要结构化字段,不将私有小说正文入库;作者之间的数据按 owner 隔离,管理员才看全量。
先把查询说清楚,再谈优化。
索引建在会话级临时表上:实验结束后自动清理,正式数据没有被写入。索引列为作品编号、章节状态、指标日期、章节号与原始字数,正好覆盖过滤、排序与聚合三件事。
缓存选的是 Caffeine 进程内实现,按「数据范围 + 工具参数」组合 Key,随机 TTL 避免同时失效,同一个 Key 的并发请求合并成一次回源;作品或章节写入后,作者与管理员两个作用域的缓存立即失效。
边界:这是进程内缓存,不是 Redis,也不是跨节点分布式锁;独立运行的 Spark 任务写回结果时没有失效通知,相关统计最长会在 TTL + 抖动(30–60 秒)后刷新。
让数据质量问题在界面上可见。
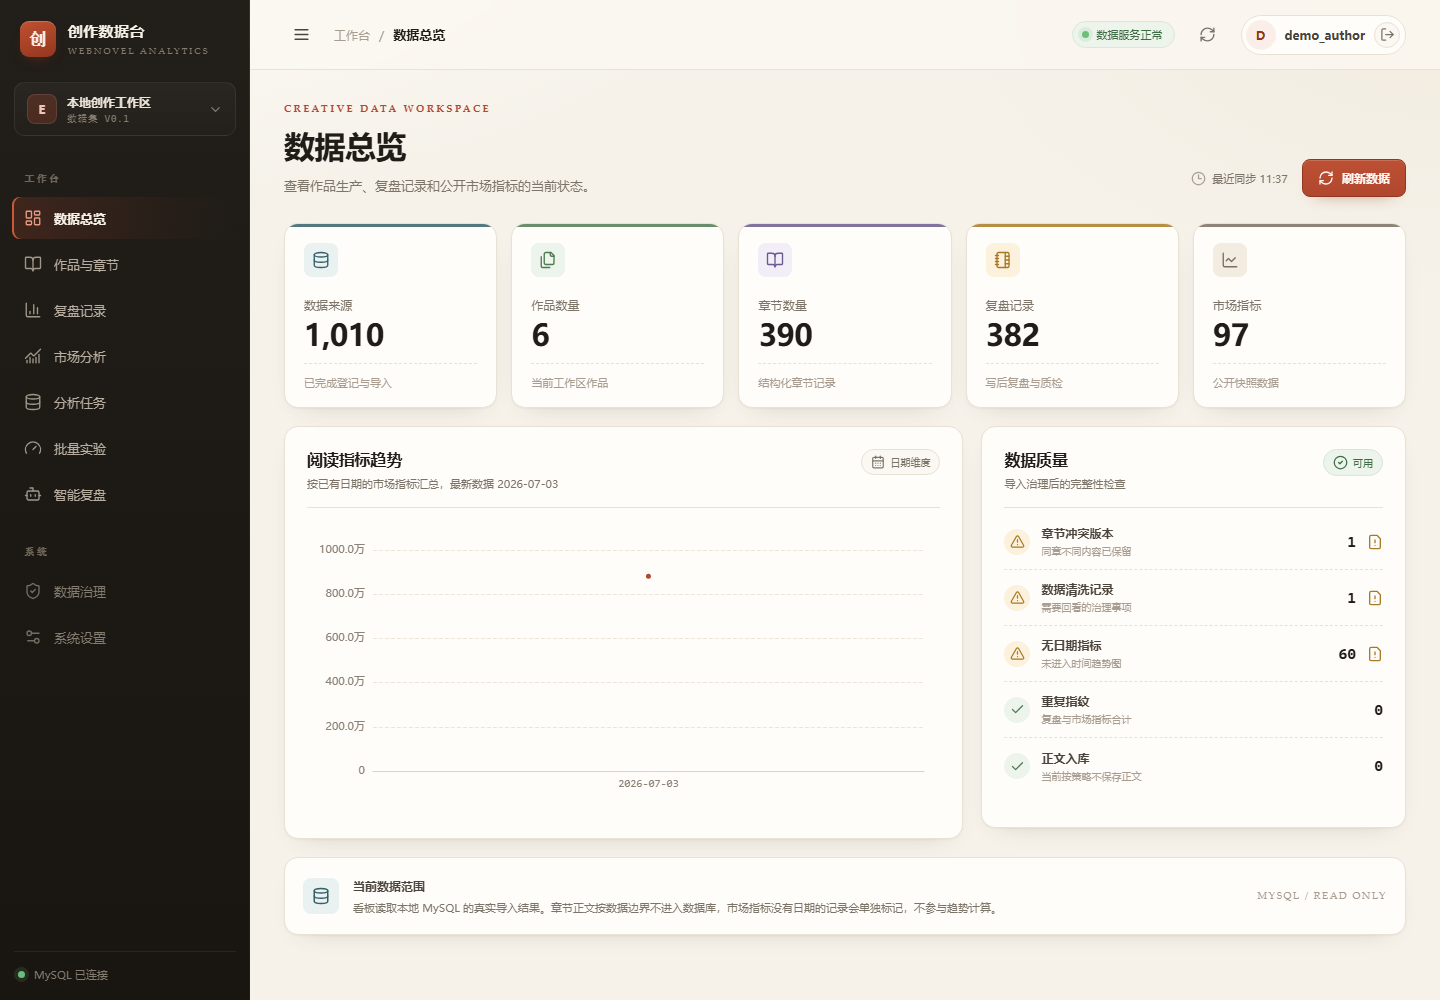
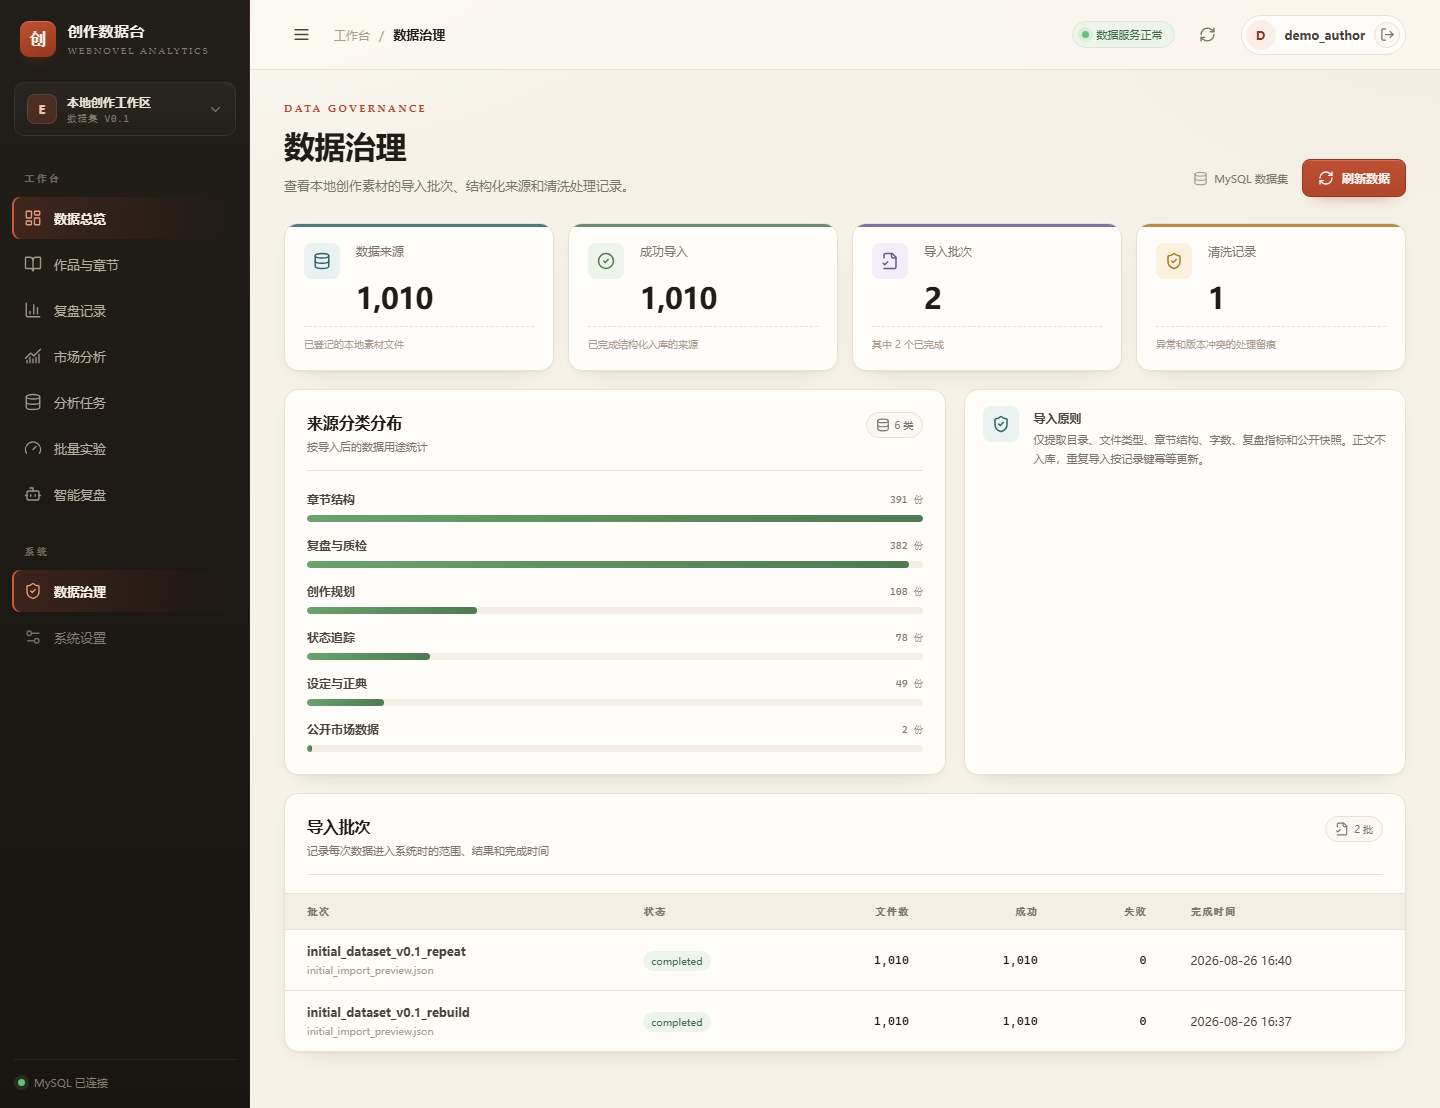
界面不仅显示数量,也把章节版本冲突、空正文、无日期指标和重复指纹单独列出来;市场快照缺日期时标注为「日期稀疏」,不参与趋势解释,避免把不完整数据包装成增长结论。
先做受控统计,而不是包装通用 Agent。
先限定查询范围与可执行动作,记录问题、工具、证据与答案;当前仍未接入 LLM。
用于验证单机批处理与聚合链路,不外推为分布式集群性能。
只优化真实的慢查询与热点读取,数字标注环境与样本量。
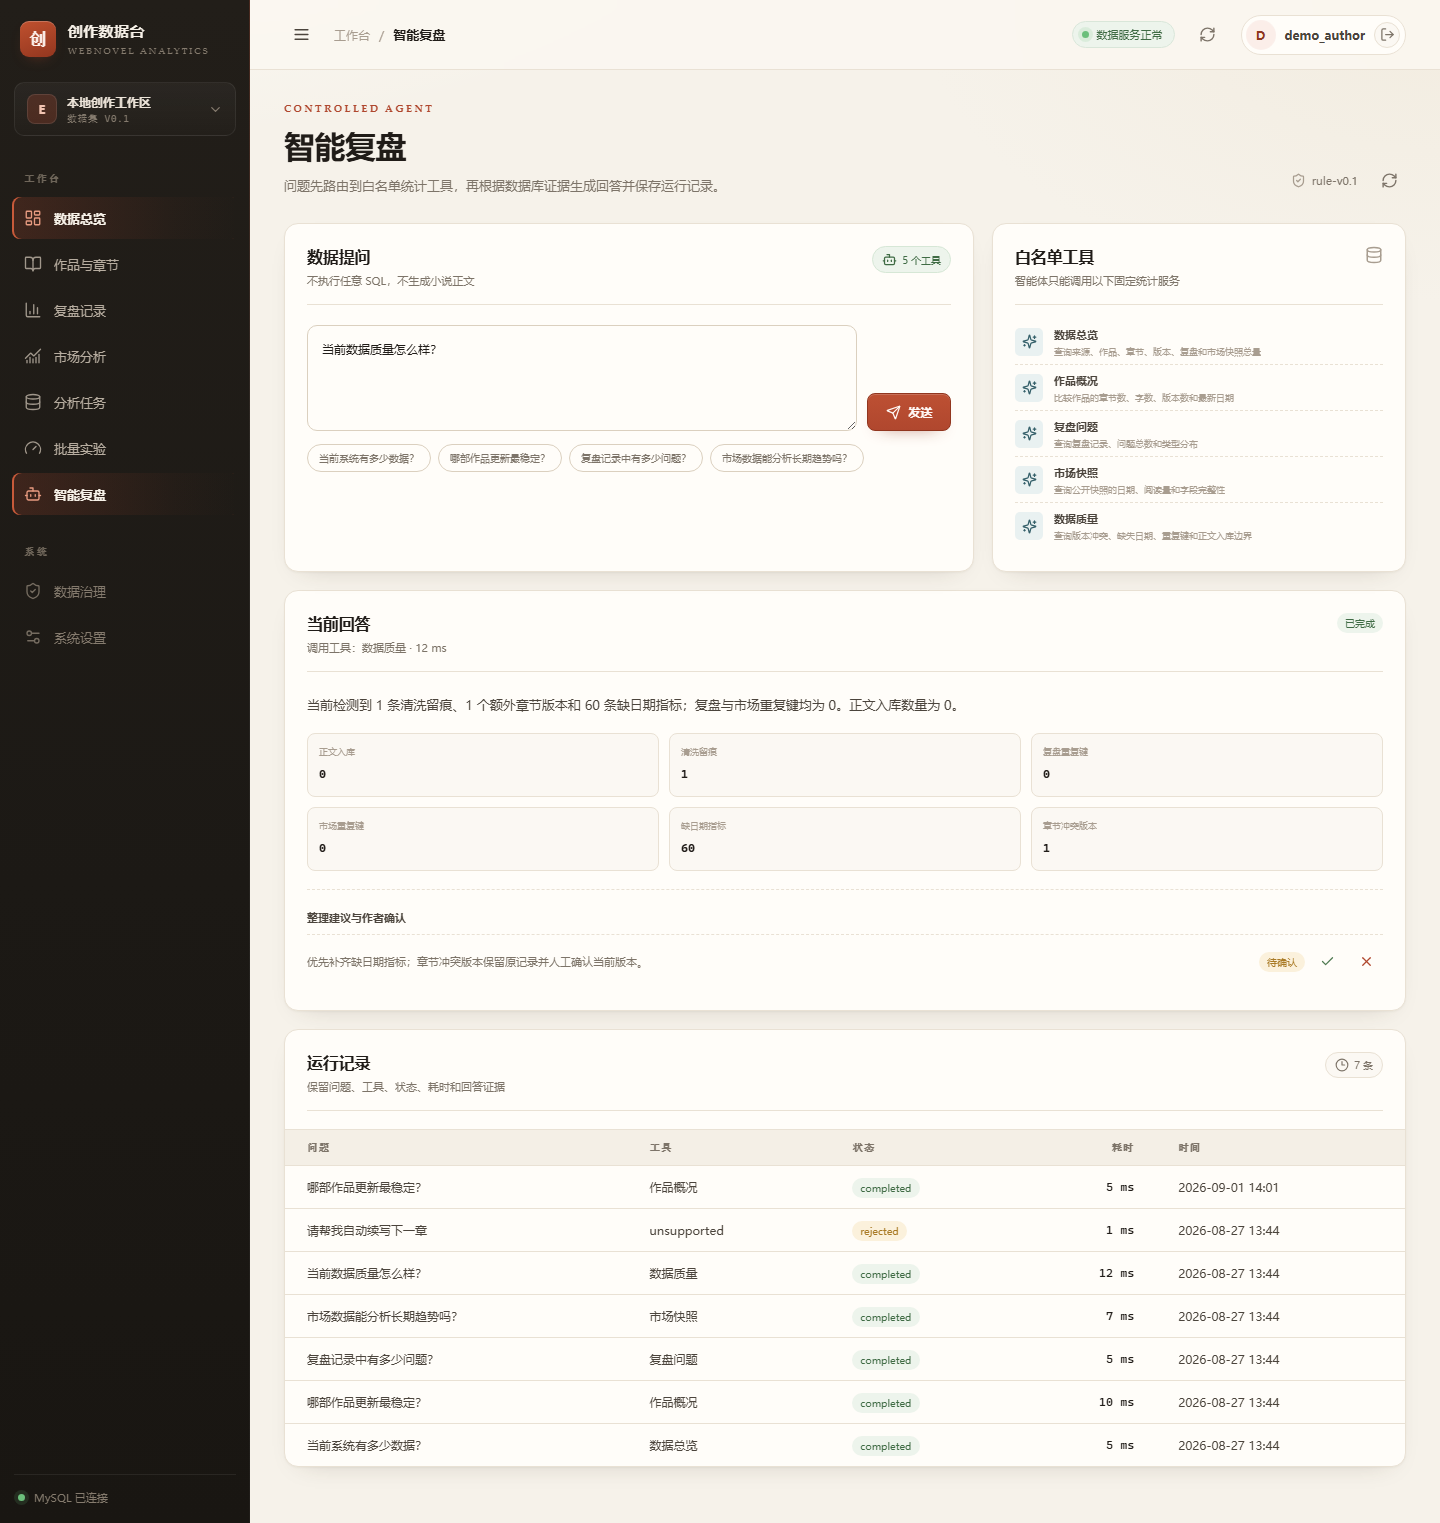
截图下半部分的运行记录里有一条 请帮我启动续写下一章,状态是 rejected:越界请求不会执行,也不会伪装成「已理解」。每条回答都保留调用的工具、耗时和证据字段,可以回查它是怎么得出结论的。
已有什么,还缺什么。
- 54 项自动化测试通过(44 项既有 + 10 项新增缓存与性能测试)。
- 索引实验与缓存微基准保留原始 JSON 与 Markdown 报告,另有独立验收记录复核了测试与实验的可复现性。
- 作者数据范围隔离在真实 HTTP 进程内验证:demo_author 只见自己的作品,demo_writer 为 0 部,管理员见全量。
- Spark Local 单机批处理:772 条结构化记录 → 6 部作品聚合指标,章节数、字数、复盘数等五项与 SQL 统计一致。
没有外部用户、留存或增长数据;这个原型的价值在流程组织、数据质量与可验证的工程优化,不是商业化成果。